

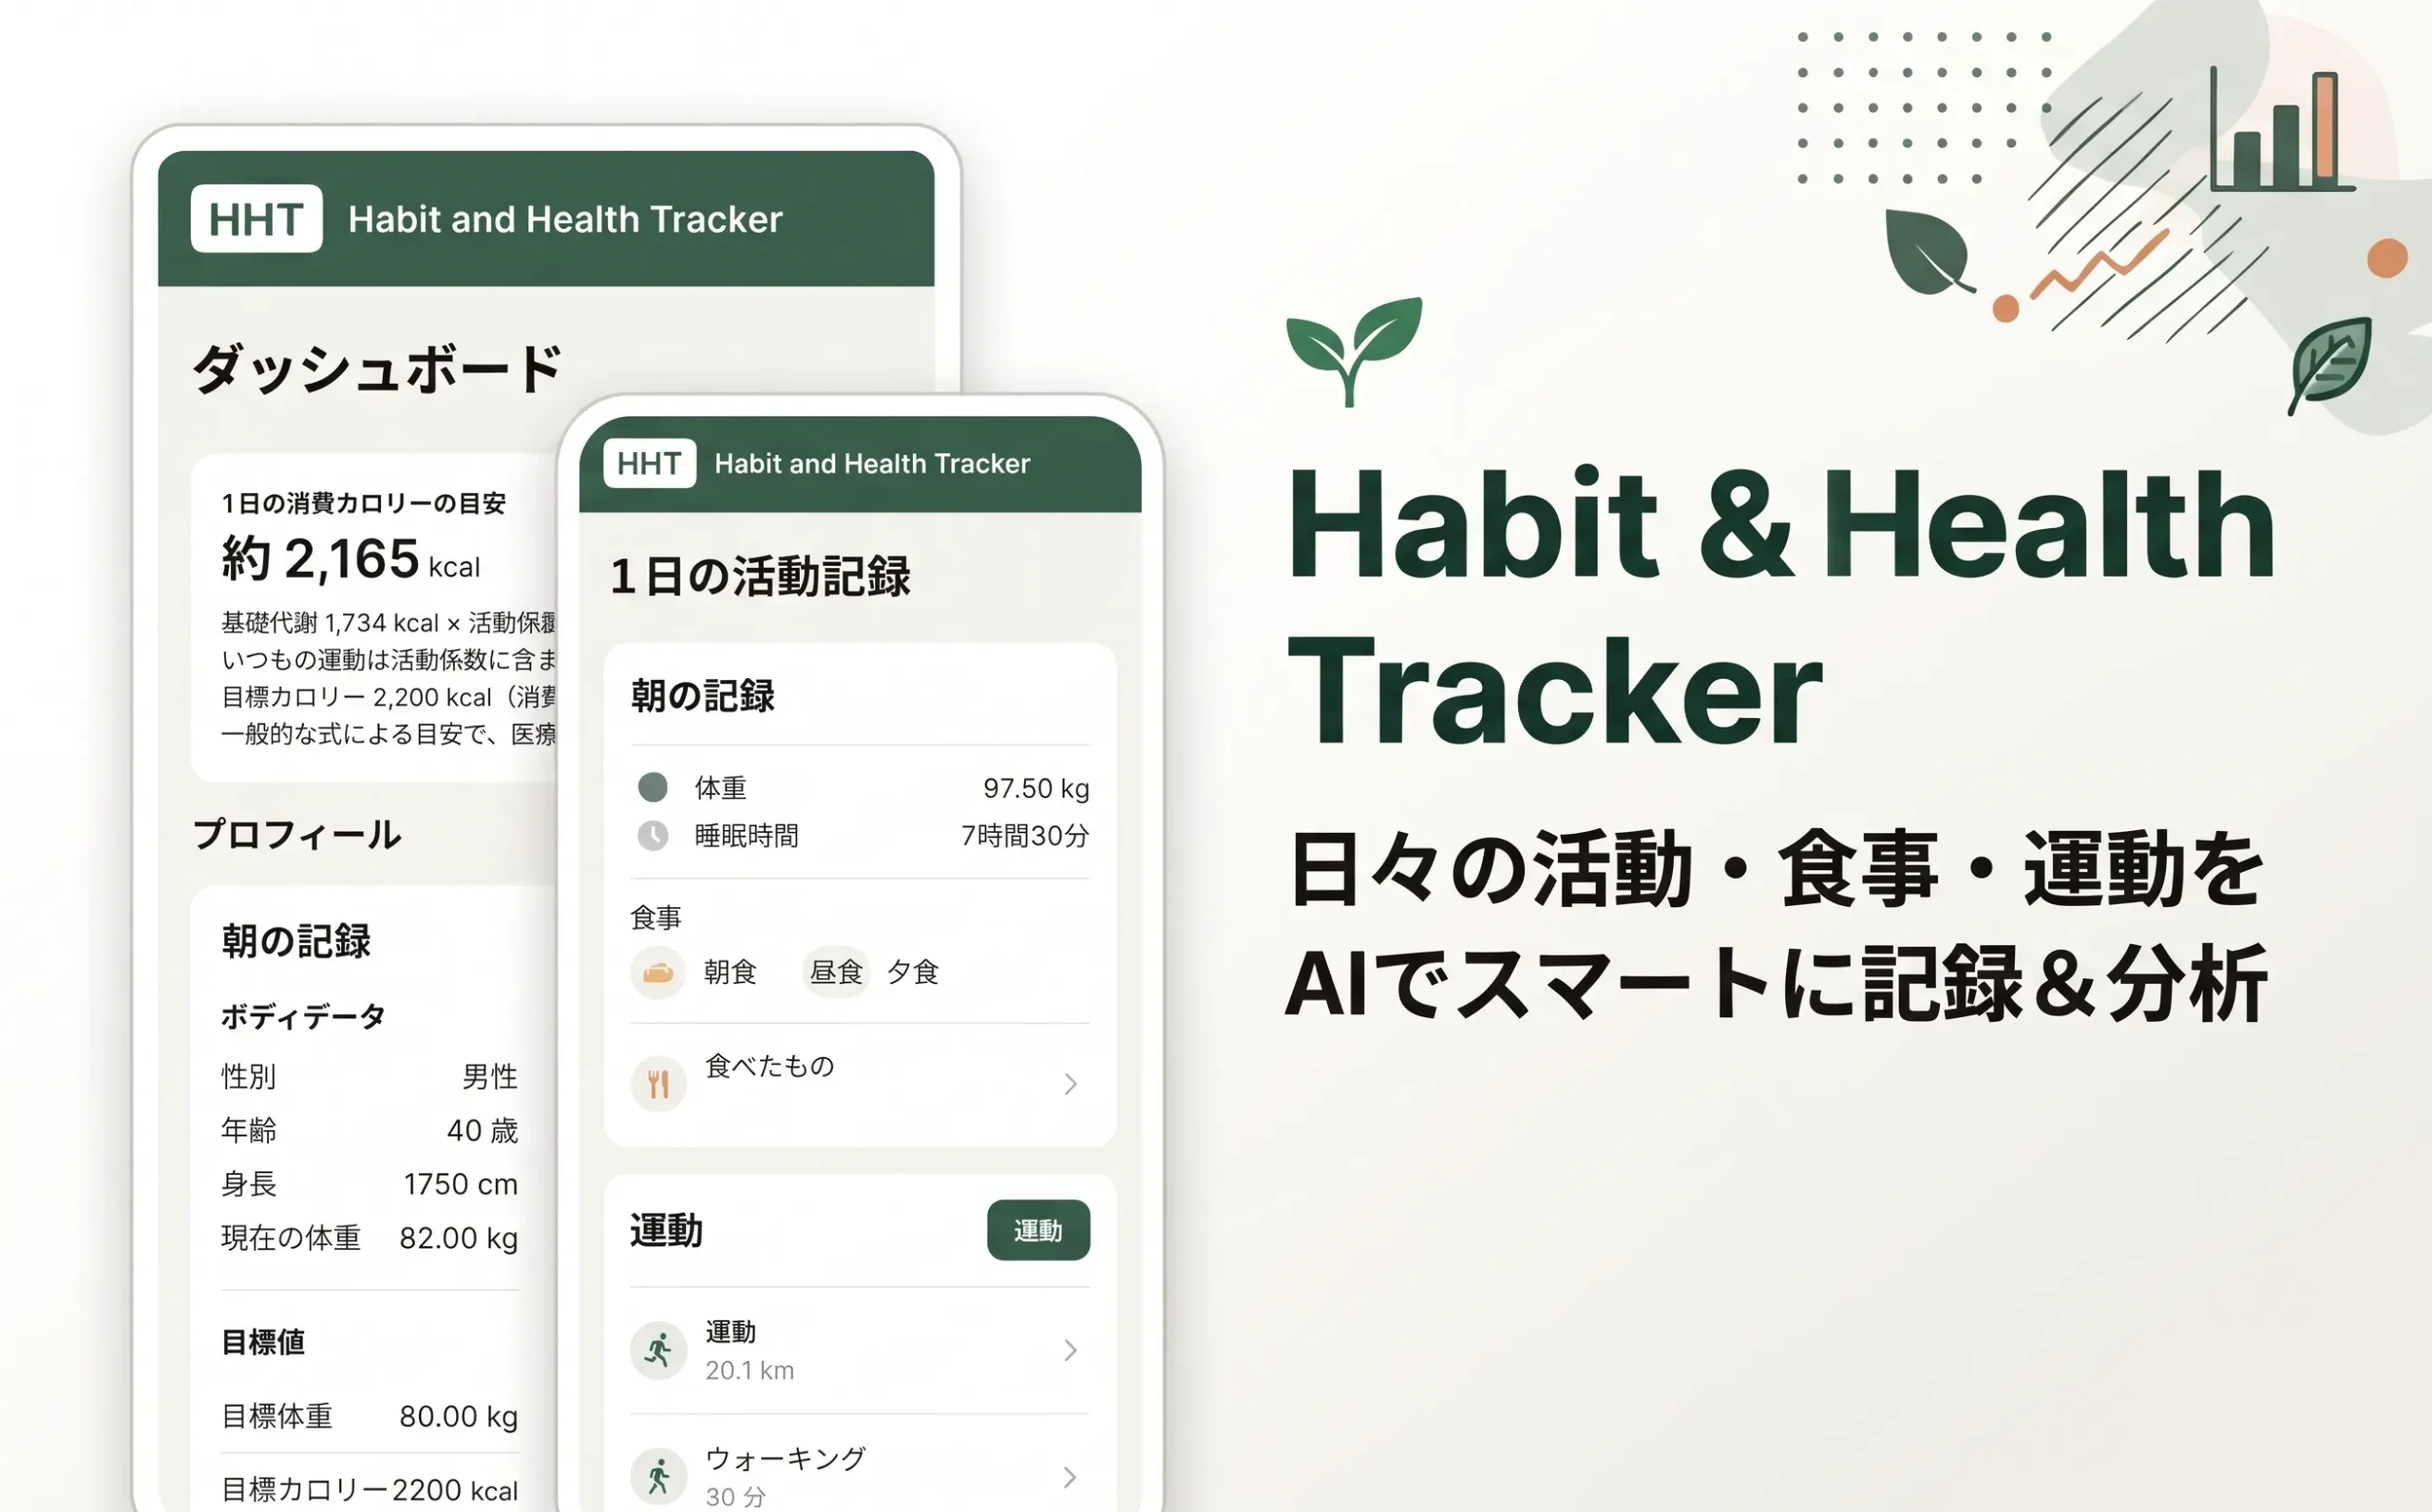
この記事はHHTの技術記事です。
サービスの紹介は以下の記事をご覧ください。
https://shu-digital-works.com/works/habit-and-health-tracker-release
Githubのリポジトリはこちら
https://github.com/shu915/habit-and-health-tracker
概要
Habit and Health Tracker(HHT) は、
「記録の手間」と「振り返りの難しさ」を減らし、
日々の生活習慣を無理なく改善するためのWebアプリです。
毎日のコンディションや習慣をシンプルに入力するだけで、
グラフによる直感的な可視化と、
AIによるパーソナルな分析・フィードバックまでを一気通貫で行えます。
自分の心と体のパフォーマンスをデータで整えたい人のためのツールです。
使用技術
| 分類 | 技術 | バージョン |
|---|---|---|
| フレームワーク | Next.js(App Router) | 16.4.2 |
| UI | React | 19.3.0 |
| 言語 | TypeScript | 5.9.3 |
| グラフ | Recharts | 3.10.1 |
| スタイル | Tailwind CSS | 4.3.3 |
| データベース | PostgreSQL(本番は Neon) | 18 |
| 開発用の DB | Docker | – |
| ORM | Drizzle ORM | 0.45.4 |
| マイグレーション | drizzle-kit | 0.31.11 |
| 認証 | Better Auth(メールのリンク+Google 連結) | 1.7.14 |
| メール送信 | Resend | – |
| 入力の検証 | zod | 4.6.7 |
| AI | OpenRouter 経由で Gemini | gemini-4-hydrogen |
| テスト | Vitest | 5.0.5 |
| テスト | Testing Library(React) | 16.3.3 |
| ホスティング | Vercel | – |
| バックアップ | GitHub Actions → age で暗号化 → Cloudflare R2 | – |
| 開発 | Claude Code | – |
画面一覧
| パス | 内容 | ログイン |
|---|---|---|
/login | ログイン(メールのリンク / Google) | 不要 |
/ | ダッシュボード(プロフィール・記録の一覧・グラフ) | 必要 |
/profile/edit | プロフィールの編集 | 必要 |
/account | アカウントの設定(Google の連結・解除) | 必要 |
/days/[date] | その日の記録の詳細 | 必要 |
/days/[date]/edit | 朝の記録(体重・睡眠など)の編集 | 必要 |
/days/[date]/meals/new | 食事を追加(AI で栄養を推定) | 必要 |
/days/[date]/meals/[id]/edit | 食事の編集 | 必要 |
/days/[date]/exercises/new | 運動を追加 | 必要 |
/days/[date]/exercises/[id]/edit | 運動の編集 | 必要 |
/days/[date]/positive | 良かったことの記録 | 必要 |
/days/[date]/reflection | 今日の気づき | 必要 |
/reports | AI レポートの作成・一覧 | 必要 |
/reports/[id] | レポートの表示 | 必要 |
/api/auth/* | Better Auth(ログイン処理) | – |
Server Action一覧
| 処理 | 内容 |
|---|---|
| saveProfileAction | プロフィールを保存 |
| recordWaistAction | ウエストを記録 |
| saveDayAction | 朝の記録を保存 |
| estimateMealAction | 食事を AI で推定(1 日 20 回まで) |
| saveMealAction / updateMealAction / deleteMealAction | 食事の保存・更新・削除 |
| saveExerciseAction / updateExerciseAction / deleteExerciseAction | 運動の保存・更新・削除 |
| savePositiveAction | 良かったことを保存 |
| saveReflectionAction | 今日の気づきを保存 |
| createReportAction | AI レポートを作成(同意が必要) |
| revokeConsentAction | AI への送信の同意を取り消す |
このアプリには、自作の API(Route Handler)がありません。
あるのは、Better Auth が持つ /api/auth/* だけです。
データの保存や AI の呼び出しは、すべて Server Action(画面のフォームから、
サーバーの関数を直接呼ぶ仕組み)で動きます。
そのため、普通の「エンドポイント表」ではなく、
画面のパス(ページ)と Server Action の 2 つの表にしました。
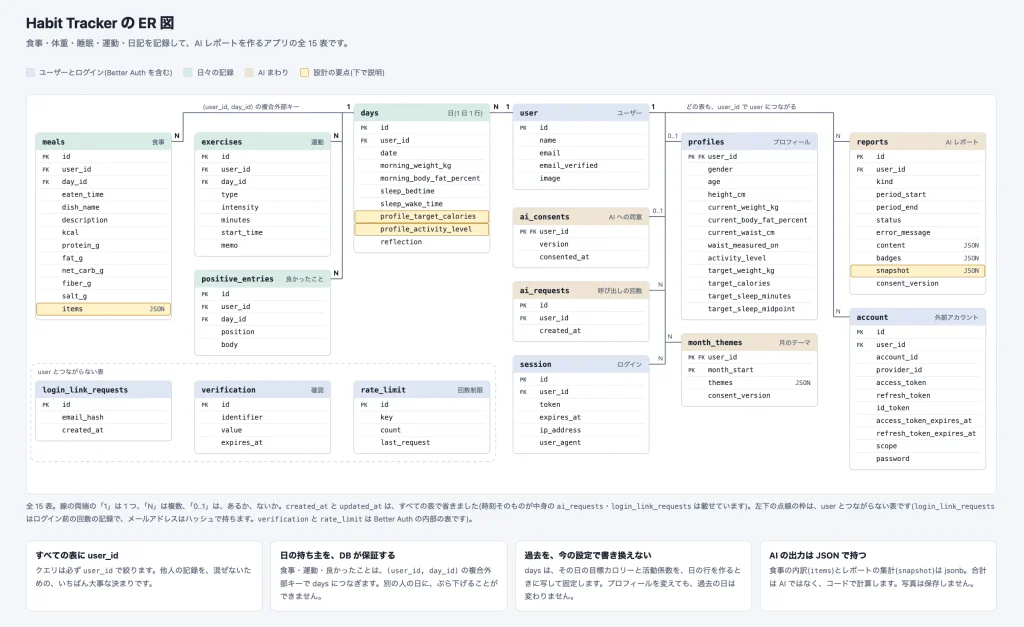
ER図
UXにこだわる
ここまではアプリの全体像やスペックの紹介でした。
ここからは、開発を進める中で自分が工夫したことや感じたことを書いていきます。
プログラミングは Claude Code、
UI デザインは Claude Design に任せることができましたが、
そのままだと使いづらかったりダサかったりするので、
UX はまだまだ人間が工夫する必要があると感じました。
そこで、ユーザーの摩擦や認知負荷を減らし、
毎日手に取りたくなるように UX に配慮しました。
日々の煩わしさを排除するように設計しています。
たとえばログインは、最初はメールのリンクで入り、
アカウントのページで Google を連結すれば、
次からは Google でワンクリックで入れます。
食事の記録は、写真をパシャっと撮ってボタンを押すだけで、
カロリーを推論できます。
AI の推定は、あとから直すこともできます。
画面の細かい部分にも手を入れました。
ダッシュボードは、読み込み中に本体と同じ大きさの影(スケルトン)を出して、
できあがったときに画面が跳ねないようにしています。
高さが少し低めなのは許し、大きく下がる・上に動くのは許さない、
という基準を決めて、PC とスマホで確かめました。
体重の入力欄には、直近 5 日の中央値を入れるボタンを置きました。
自動で書き換えず、本人が確認して保存する形にして、
勝手に値が変わる不安をなくしています。
テストを大量に書く
AI にコードを書かせると、速く書ける一方で、
壊れたことに気づきにくくなります。
そこで、テストを大量に書かせて縛ることにしました。
今は 110 ファイル、約 1,400 件です。
ただし、数が目的ではなく、壊れると困る場所を種類ごとに固定することが目的です。
ユニットテストは、
カロリーの推移や運動の消費カロリーなど、入力から出力が決まる関数を、
DB も画面もなしで確かめます。
速いので、実装のたびに回せます。
エッジケースは、
バグが出やすい境目をわざと試します。
たとえば、日本時間の 02:59 は前の日、03:00 は新しい日、と固定しています。
1 日に記録できる食事は 20 件までで、21 件目は保存されないことも確かめます。
入力欄に、空欄・負の数・小数・文字が入った場合も、同じように試します。
DB を使ったテストは、
モックではなく、本物の PostgreSQL で動かします。
データの分離や同時実行の制御は、モックでは確かめられないためです。
他のユーザーのデータが見えない、ユーザーを消すとその人の記録だけが消える、
同時に 10 件送っても通るのは上限の 3 件だけ、といったことを固定しています。
画面のテストは、
擬似ブラウザ(jsdom)にフォームを描画し、
Testing Library で入力やクリックをして、画面の文字を確かめます。
AI のテストは、2 つに分けています。
AI を呼ばない普通のテストでは、返事の検証を確かめます。
zod で検証し直す、合計はコードで計算し直す、
範囲外の値は断る、といった部分です。
実際に AI を呼ぶ live テストは、お金がかかるので、環境変数 RUN_LIVE_AI=1 のときだけ動かします。
テストが落ちたら、まず実装が間違っていると考えます。
テストの削除・skip・期待値を弱める・型や lint を黙らせる、といった改ざんは禁止にして、
フックでもブロックしています。
AI に任せるほど、このルールが効きます。
E2E テストは入れていません。
認証がマジックリンクで自動化の費用が高く、守りの要所は DB を使ったテストで固定しているためです。
AI の入出力を制御する
このアプリの中心は、食事の写真や文章から、AI が栄養を推定する部分です。
AI は便利ですが、そのまま信じると、数字が合わない、
おかしな入力で壊れる、費用が際限なく増える、
という問題が出ます。そこで、AI の前後に、コードで制御を入れました。
入力側(AI に渡すもの)
まず、食べ物でないものを入れさせません。
靴や薬、人や動物が写っているだけの写真などは、
推定を作らず、理由を返して、何も保存しません。
判断は、プロンプトで AI にさせています。
次に、写真は保存しません。
AI に渡すためだけに使い、AI が返した JSON だけを保存します。
食事の内容や写真は健康情報なので、OpenRouter への送信には、
学習などに使わせない設定(data_collection: "deny")も付けています。
日記の全文を AI に送るのは、利用者が同意して、レポートを作るときだけです。
回数にも上限があります。食事の推定は 1 日 20 回までです。
AI に届かなかった失敗(接続エラーなど)は数えず、AI が答えたあとの失敗は数えます。
後者を数えないと、わざと失敗させて、上限なしに AI を呼べてしまうためです。
同時に何本送られても超えないよう、ユーザー単位でロックして、「数える→足す」を直列にしています。
プロンプトの工夫
写真から分かるのは、見た目(品目と量)までです。
油や砂糖は目に見えないので、プロンプトで、織り込むよう指示しました。
調理法に応じて、焼く・炒める・揚げるなら油を足し、
ノンフライヤーや蒸し料理なら足さない。
甘辛いたれには、砂糖の分を足す。
調理法が分からないときは、外食や総菜なら、
油と砂糖を使った一般的な調理を仮定して、仮定したことを品目ごとに書かせます。
画面で「何を前提にした数字か」が見えるようにするためです。
調整は、自動の評価ではなく、手で試しました。
高カロリーの食事、低カロリーの食事、成分表のある食品、自分が実際に食べたものを、
何度も渡して、結果を見ます。
モデルも、複数を比べました。
モデルごとに、細かい栄養値の精度や、速さ、費用が違います。
ただ、どのモデルも、写真の読み違いはします。
たとえば、いくらの醤油漬けを、佃煮と読み違えることがありました。
そこで、精度・速さ・費用のつり合いで、そのときに合うモデルを選び、
その後、より新しいモデルに切り替えました。
モデル名は環境変数で変えられるので、切り替えは、コードを直さずにできます。
出力側(AI が返したもの)
AI の返事は、そのまま保存しません。
一番大事な決め事は、足し算を AI にさせないことです。
合計カロリーや糖質は、品目ごとの内訳から、コードで計算します。
保存のときも、サーバーが推定を zod で検証し直し、合計を内訳から再計算します。
AI の返事のばらつきや、計算違いが、そのまま記録に入らないようにするためです。
時間のかかる処理
AI レポートは、作るのに時間がかかります。
そこで、作成を押すと、すぐに返事を返し、AI の呼び出しは裏で続けます。
画面には「作成中」と出し、終わると、一覧が更新されます。
実行時間の上限を延ばし、AI の呼び出しには、時間切れ(120 秒)と、失敗時のやり直しを入れました。
AI の出力は、ばらつきます。
だから、プロンプトで寄せ、コードで計算し、zod で検証し、上限で守る、
という何重もの制御を、前後に置いています。
理想の値と、現実の値の折り合い
栄養のバランスは、レーダーチャートで、目標との比べを見せています。
ここで、目標の決め方に悩みました。
国が出している目標量は、塩分が男性 7.5g・女性 6.5g 未満、
食物繊維が 25g 以上(WHO の目安を参考にした値)です。
これを、そのまま 100% にすると、ふつうの食事をしても、
塩分は大きく突き抜け、食物繊維は届かない、という歪んだグラフになります。
ほとんどの日が「未達成」に見えて、やる気を下げてしまいます。
そこで、100% の基準を、実際の日本人の摂取量に近い値にしました。
塩分は 10g、食物繊維は 20g です。
国民健康・栄養調査の平均が、塩分で 9〜10g 台、食物繊維で 19g 台だったためです。
さらに、100% の一点ではなく、その前後に薄い帯(塩分は 8〜12g、食物繊維は 16〜24g)を引き、
帯の中なら「目標に近い」と見せます。
人によって適量が違うので、ざっくり幅の中ならよい、という考え方です。
軸ごとに、向きも変えています。
塩分は超えないほうがよく、たんぱく質は届くほうがよく、
そのほかは近いほどよい、としています。
表の一言も、この向きに合わせて変わります。
これは、一般的な参考値で、医療上の指示ではありません。
画面にも、そう書いています。
理想を捨てたのではなく、毎日見て、続けられる基準を選んだ、という判断です。
デプロイ前に、Fable5.2で 2 回レビューさせる
普段の開発でも、コードを書いたあとには、レビュー用の AI(evaluator)に見せています。
型チェック・lint・テストは、自動で動きます。
ただ、本番に出す前は、別扱いにしました。
使う人の健康情報を預かるアプリなので、普段より重い高性能なモデル(Fable)に、
公開前のレビューを 2 回させました。
コードを書いたセッションとは別の画面で、まっさらな状態から見てもらったので、
書いた側の思い込みを引きずりません。
指摘された内容は、すべて直しました。直すときは、追加のテストも書きました。
デプロイ前は、普段より少し念入りに、が合っていました。
コストはかかりますが、公開してから直すより、はるかに安いと感じています。
DB を毎晩バックアップして、R2 に置く
本番の DB(Neon)は、無料枠だと、戻せるのが 6 時間前までです。
健康情報を預かる以上、それでは足りないので、
毎晩、DB をバックアップして、Cloudflare R2 に置くことにしました。
流れは、GitHub Actions が、pg_dump で DB を書き出し、
暗号化して、R2 に保存する、というものです。
暗号化には、age を使い、公開鍵で暗号化します。
復号に必要な秘密鍵は、自分の手元にしか置きません。
GitHub や R2 のアカウントが漏れても、中身は読めません。
ワークフローでは、外部のアクションを使わず、リポジトリのコードも読ませていません。
古いファイルは、R2 の自動削除のルールで消えます。
実際に動かして、気づいたことが 2 つあります。
1 つ目は、GitHub Actions の定時実行は、数時間遅れることがあることです。
夜中の 3 時を狙って設定したのに、実際には 4〜5 時間遅れました。
毎時 0 分や 30 分は混みやすいので、時刻を 0:17 にずらし、
遅れても朝までには終わるようにしました。
2 つ目は、公開リポジトリは、60 日間更新がないと、定時実行が止まることです。
止まっても通知は来ないので、気をつけたい点です。
バックアップは、取れているだけでは足りません。
戻せなければ、意味がありません。
そこで、R2 から取り出して復号し、
空の DB に戻す手順を、実際に試しました。
本番には戻さず、別の DB で、
データが元どおりに入ることを確かめて、成功しました。
まとめ
AIに任せられるものはAIに任せつつ、
それ以外は自分で制御することによって、
アプリを作り上げることができました。
使いながらちょくちょく改善していきたいと思います。
サービスの解説はこちら
https://shu-digital-works.com/works/habit-and-health-tracker-release